Dogtor Robotics · 2026 年技术调研
Dogtor 机器人系统技术调研与选型评估
面向 E 栋接待与科普场景,对比启元 T1 具身移动平台与 Reachy Mini 桌面机器人两条路线。梳理开源实践的分层架构、动作安全机制与现场验证条件。
Dogtor Robotics 项目组
研究资料 · 供方案讨论 · V1.0 · 2026 年 11 月
资料查阅日期:2026 年 11 月 3 日
第一章 · Executive Summary
执行摘要
Dogtor 的目标是在 E 栋为访客提供欢迎、院所介绍和经审核的科普问答。本报告系统评估两条硬件路线:具身智能(启元本体候选)负责接待与受控动作,桌面机器人(Reachy Mini)验证语音与角色表达;两条路线分别制定方案,先在固定场景做稳,再谈扩展。
优先让 Dogtor 在固定接待场景中稳定交流,再根据本体能力和场地条件扩展动作与移动。具身智能路线以启元本体为候选,桌面路线以 Reachy Mini 为优先研究对象:前者解决接待与受控动作,后者验证语音与角色表达;两条路线分别设计对话、知识与动作系统,并各自进行验证。
报告分两个板块:第一板块研究具身智能,以启元本体为候选,参考 PawAI、Go2Agent 的感知、技能和安全分层;第二板块研究桌面机器人,以 Reachy Mini 为优先研究对象,借鉴其官方对话应用和 Furhat 的语音动作设计。
当前仓库只有文本回复与模拟动作;本报告中的建议路线均以待验证方案的形式陈述,能力结论以公开资料为据,须逐项实机核验后方可对外承诺或排期。
核心结论
- 启元与 Reachy Mini 分别设计接待、知识检索、动作与安全方案,并独立验证。
- 公开案例的共识是分层与受控:PawAI 按安全、策略、表达分层并由统一执行器仲裁;Go2Agent 把动作收敛为带超时与反馈的技能目录;模型只提出技能名,不直接输出运动指令。
- 首期只承诺定点接待:预设欢迎动作加审核知识问答;自主行走、导航与多人嘈杂环境不在首期范围。
- 文中“已有结果”均来自项目与厂商公开描述,并非本项目实测;每项能力需按版本逐项实机验证后才可对外承诺。
本文档回答的问题
两条路线各自的公开实现做到了什么、边界在哪里?哪些能力可以直接借鉴到 Dogtor 的接待场景?下一步要先验证什么、向谁确认什么?
第二章 · Background
背景与两条技术路径
机器人形态尚未确定,因此按本体能力分两条路线研究;两条路线分别制定接待方案和验收要求,独立进行验证。
接待场景与现状
Dogtor 是院所吉祥物,目标场景是 E 栋接待与科普:欢迎访客、介绍院所、回答经审核的常见问题。项目当前处于需求梳理和软件原型阶段,机器人型号、现场条件和立项范围尚未确定。
具身智能路线以接待与受控动作为主:第一阶段做定点迎宾、知识问答和少量动作,移动引导单独验证。桌面机器人路线以语音与角色表达为主:先在仿真中打磨中文问答和头部表现,再转实机。
工程边界:调研引用参数源自候选厂商及开源项目公开白皮书;目标效果为建议研发范围。当前仓库已实现文本接待逻辑与动作模拟器(Mock Runtime),真机接入须经过物理急停与安全仲裁验证。
第三章 · Embodied AI
具身智能:开源实践与落地架构
以启元本体为候选,从三个公开项目确认可借鉴的分层与受控做法:PawAI 提供感知与执行仲裁的分层样板,Go2Agent 提供技能运行时的工程样板,Pepper 医疗接待项目提供业务后端分离的参考。建议路线是启元本体 + 独立接待服务 + 安全技能层,首期只做定点迎宾、知识问答和少量预设动作。
候选本体:启元 T1
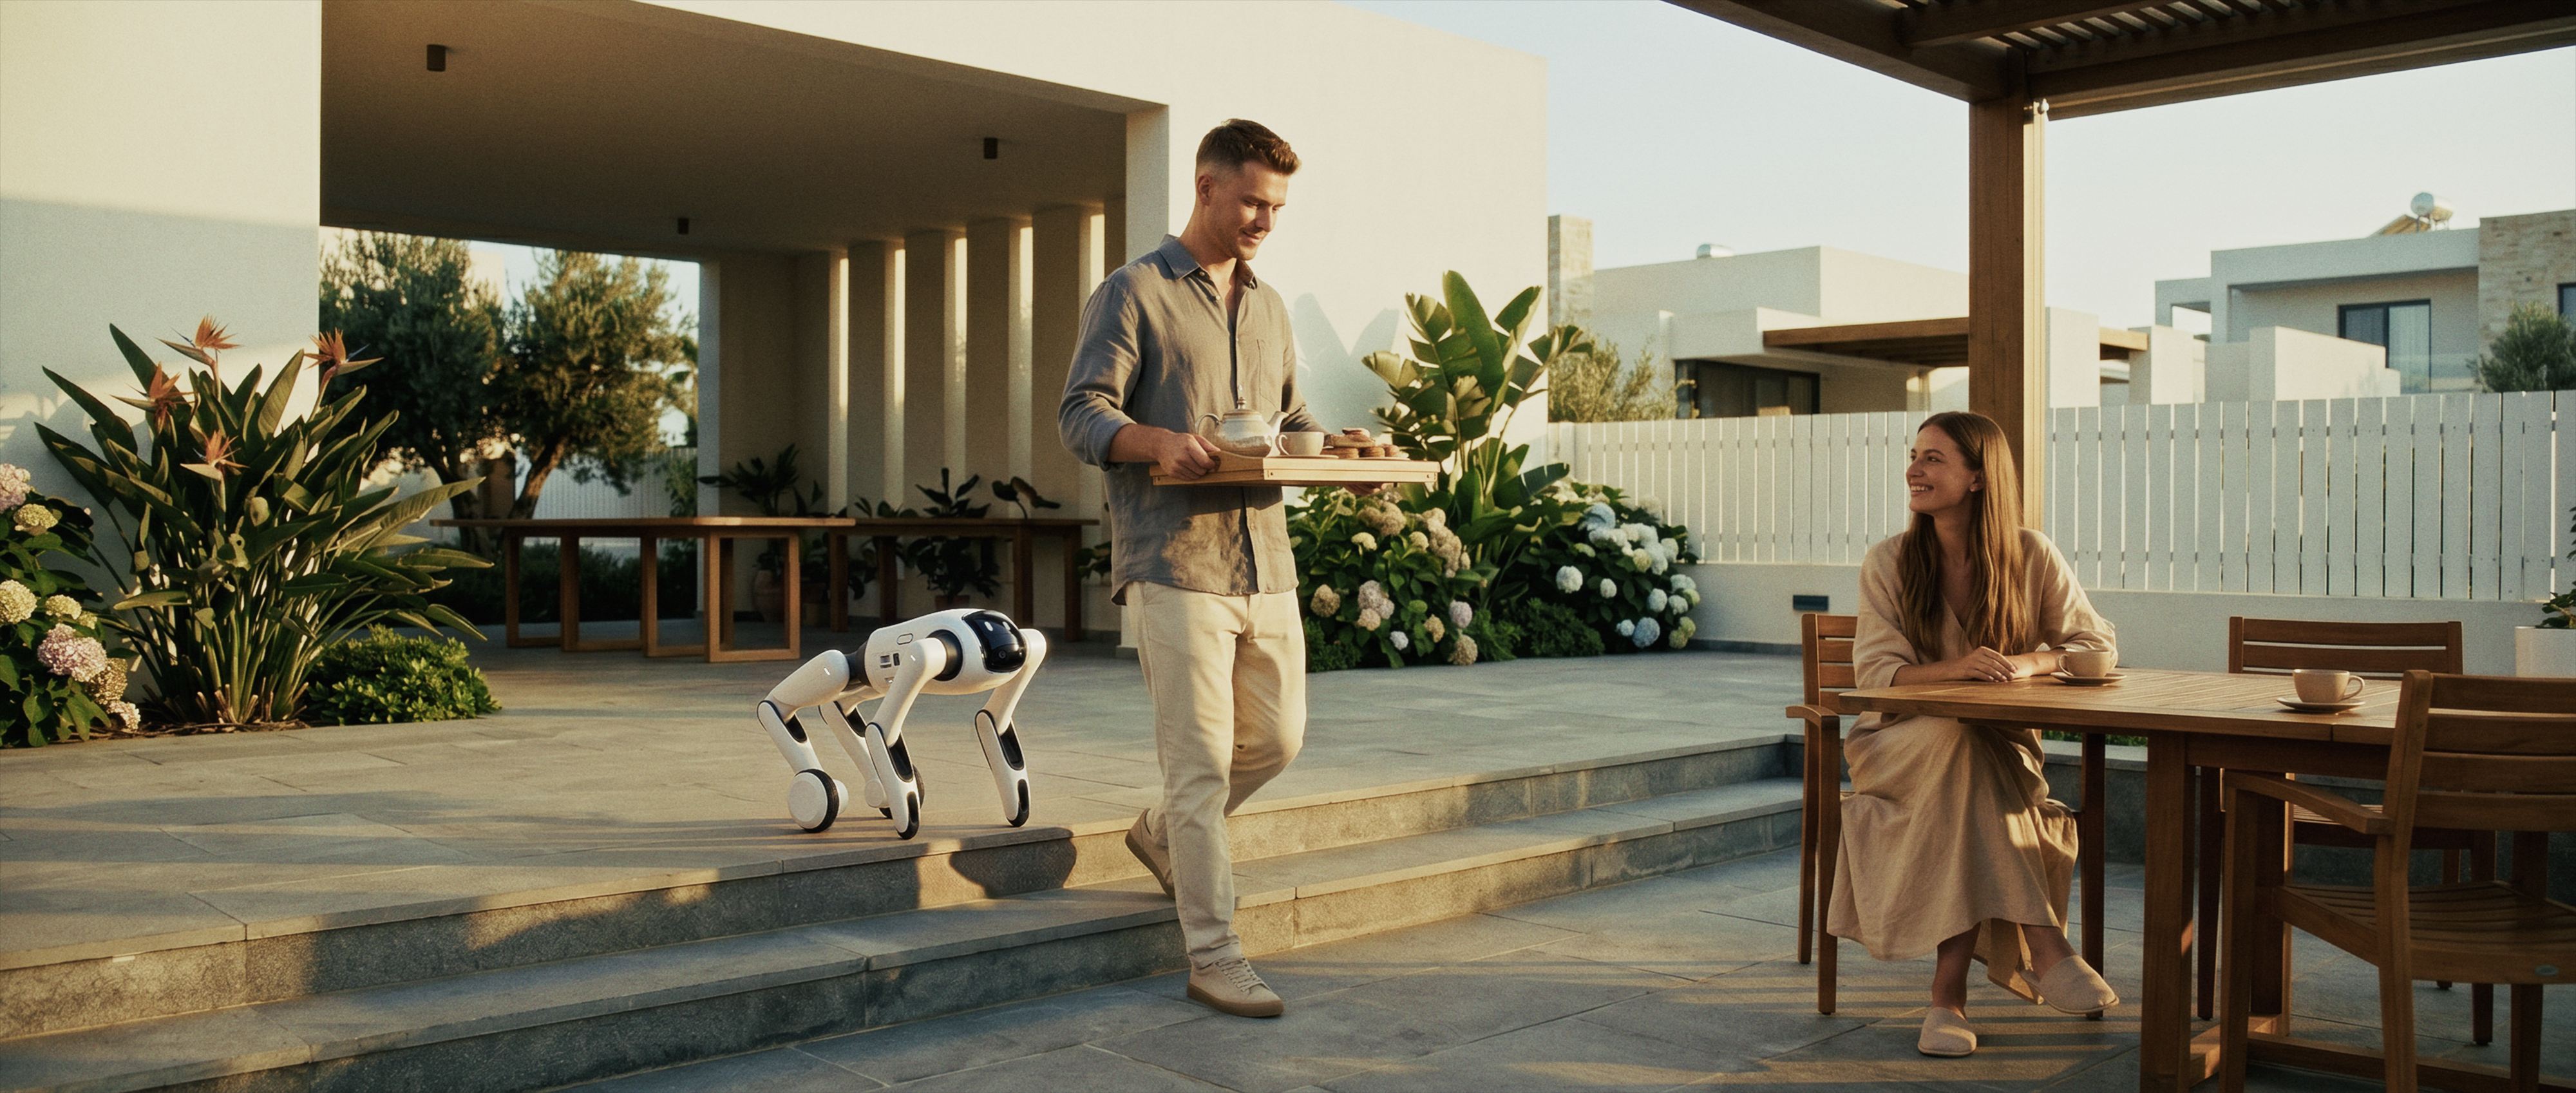 启元 T1 官方产品展示(四足形态) · 产品与演示
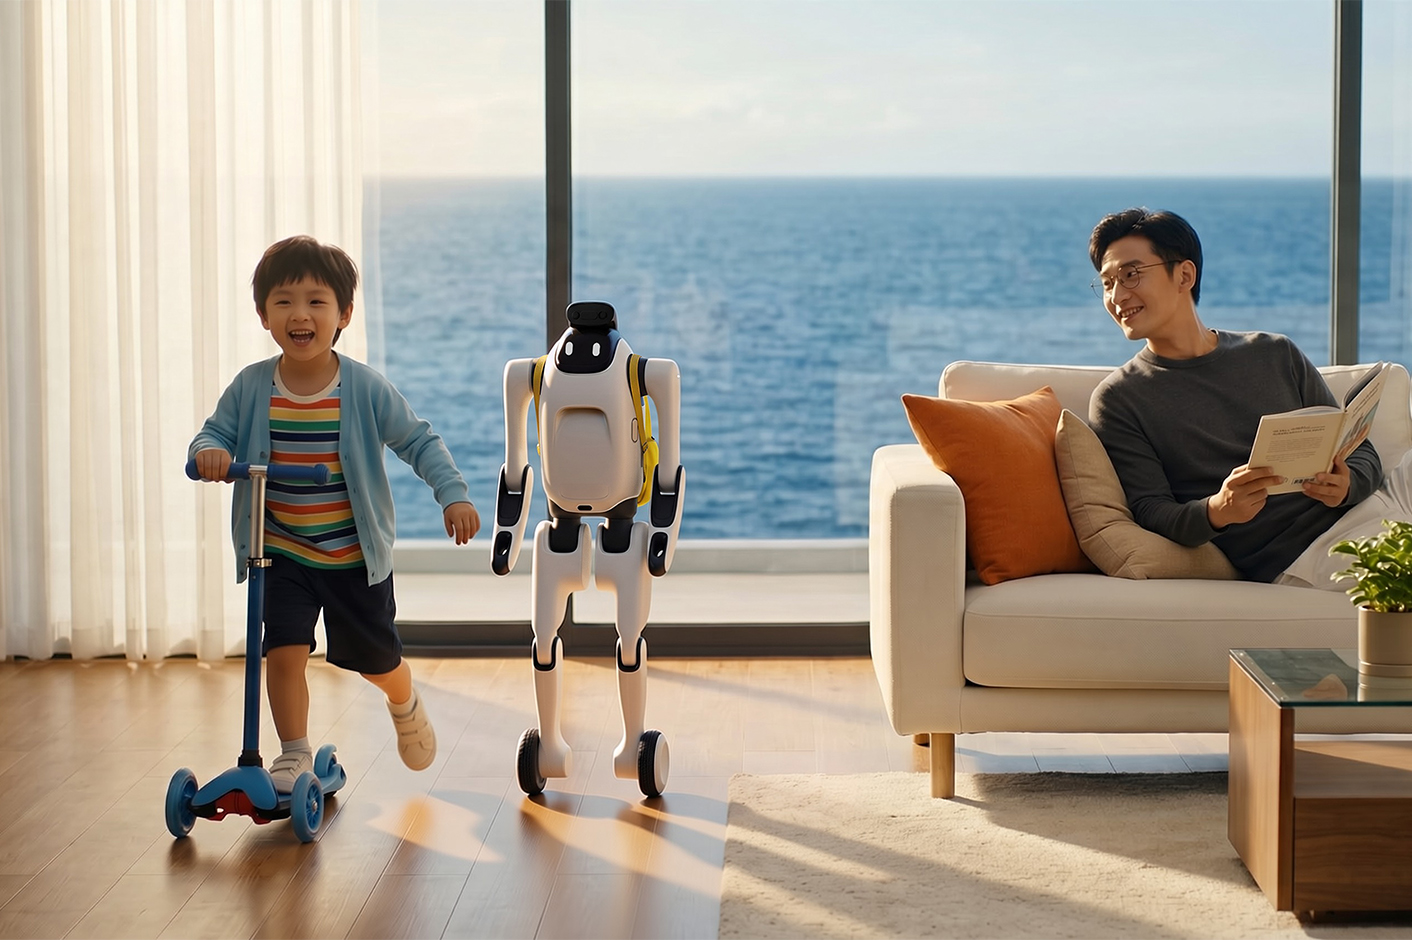 轮足人形形态 · 启元官网场景示意
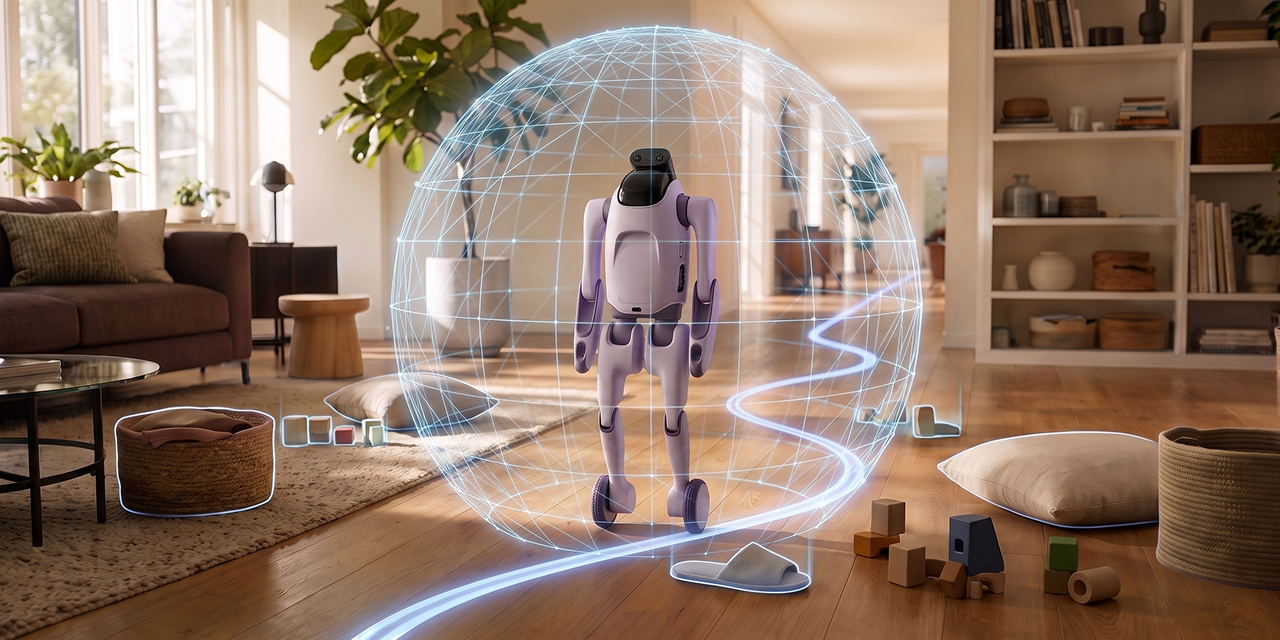 周边感知概念示意 · 启元官网;能力需实机核验
启元 T1 系列可在轮足人形与四足形态之间变形;官方标称身高 100 厘米,T1 与 T1 Pro 含电池重量分别约 16.3 与 16.8 千克。原有外形并非狗形,吉祥物改装仍需验证。
官方参数页将二次开发 SDK 列为 T1 Pro 标配、T1 无此配置;Pro 的自动变形、室内导航及自主回充标注需后续 OTA。配置、接口和实机表现仍需核实。查看官方型号对照。
开源方案与工业实践剖析
选择与四足交互、技能执行和接待业务直接相关的公开项目;候选本体以启元为入口,能力要逐项确认,不能由 SDK 名称推断实机表现。
PawAI · 四足机器人感知与执行仲裁方案 四足多模态交互 / 研究项目
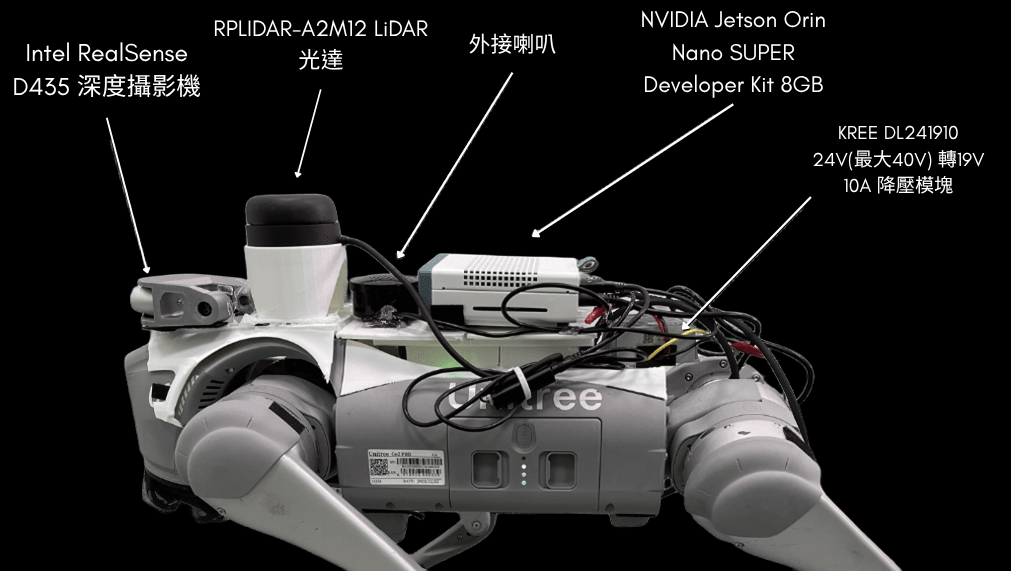 PawAI 硬件介绍 · 图片来源 · 观看项目演示
技术路线:Unitree Go2 Pro 加 Jetson Orin Nano;ROS 2 感知节点处理人脸、手势、姿态和物体,语音经 ASR、语言模型与 TTS;决策层按安全、策略、表达分层,由统一执行器仲裁技能,再交给机器人驱动。
公开结果与边界:仓库展示识人问候、手势交互、语音、动作和找物等能力,并提供演示;导航标为实验性功能,且未纳入其论文评估。仓库默认配置与论文评估版本不完全相同,效果需按版本复现。
Dogtor 可参考:参考感知、决策、驱动的分层,以及动作统一出口和状态记录;第一期只引入来人触发、语音和少量动作,不照搬识人或导航。Go2 驱动不能直接用于启元。
Go2Agent · 让模型调用有限技能 本地语音与技能 / 开源演示
技术路线:语音经 Whisper 转文本,Agent 调用工具,再经 SkillRuntime、RobotSkill 和 Go2 适配器连接 SDK;仓库提供模拟适配器与本地语音路径。执行器提供资源锁、超时、验证与清理。
公开结果与边界:仓库提供文本、语音、控制台和真机接入路径,默认可用模拟适配器。项目说明 SDK 接受姿态指令不等于物理动作已经完成;硬件依赖 Go2、网络和相应环境。
Dogtor 可参考:定义欢迎、点头、停止等带参数与返回状态的技能;先用模拟器测试超时与冲突,再由启元适配器实现。以设备反馈确认动作状态,不把模型回复当成执行成功。
Pepper Medical Assistance · 接待业务与知识检索 医院接待 / 毕业项目
技术路线:项目使用 Pepper 与独立 AI 后端,结合 Whisper、在线或本地语言模型、FAISS 检索及业务工具,通过桥接层连接机器人端和现代后端。
公开结果与边界:项目描述双语接待、知识问答、导航等功能,并列出测试;这是项目方的毕业项目成果描述,不能据此推断临床有效性或在本院可直接部署。
Dogtor 可参考:借鉴机器人与业务后端分离、审核资料检索和业务工具接口。首期只覆盖公开介绍与科普,不引入医疗诊断、患者身份识别或预约系统。
推荐系统架构与工程链路
建议路线:启元本体 + 独立接待服务 + 安全技能层;链路为麦克风 / 文本 → 语音识别 → 知识检索与对话 → 技能请求 → 安全仲裁 → 启元适配器 → 官方 SDK。
1 · 本体与接口
先确定具体机型、外形、固件、授权和网络。启元 T1 SDK 提供 ROS 2 开发、消息与 Python/C++ 示例;先只读验证状态、音视频接口,再与厂商核对允许调用的动作和急停能力。官方参数页将二次开发 SDK 列为 T1 Pro 标配、T1 无此配置;还需核对交付版本与权限。
2 · 接待对话与知识
以普通话语音识别 → 审核资料分段检索 → 语言模型依据检索内容回答 → 语音合成串联起步;记录引用来源与版本。没有依据或问题超出范围时说明不知道并提示工作人员。先用公开资料做测试集。
3 · 动作与安全
将动作建成有限技能目录,每项定义前置条件、参数边界、超时、取消和反馈;模型只能提出技能名。独立仲裁检查设备状态和权限,底层急停、人工接管及失联处置由厂商和现场方案保证。
4 · 视觉与移动
首期先用按键或工作人员触发迎宾;如确有需要,再测试仅检测访客位置的视觉方案。移动引导需另行确认定位、地图、避障、限速和现场安全,不能因 SDK 存在而默认具备。
阶段目标效果
在工作人员看护的固定区域内,访客发起交流后,Dogtor 能介绍院所、回答经审核的常见问题,并在本体支持且安全条件满足时做预设欢迎动作。模型、语音、SDK 和实机均需逐项联调;自主行走不属于首期承诺。
第四章 · Desktop Robotics
桌面机器人:多模态对话与拟人微动作
以 Reachy Mini 为优先研究对象:官方 Conversation App 组合实时语音、角色设定与编排动作,Furhat 提供事件驱动表达的编排参考。建议路线是仿真 → 接待对话 → 桌面实机,先验证交流,再确认硬件和外观;桌面版独立设计对话、知识与动作方案。
开源方案与工业实践剖析
一个可直接研究的软件平台,加一个表达设计参考。
Reachy Mini Conversation App · 语音、视觉与动作协同 桌面平台 / 官方开源应用
ESP-Ditto 滴豆 · 桌面智能硬件示范
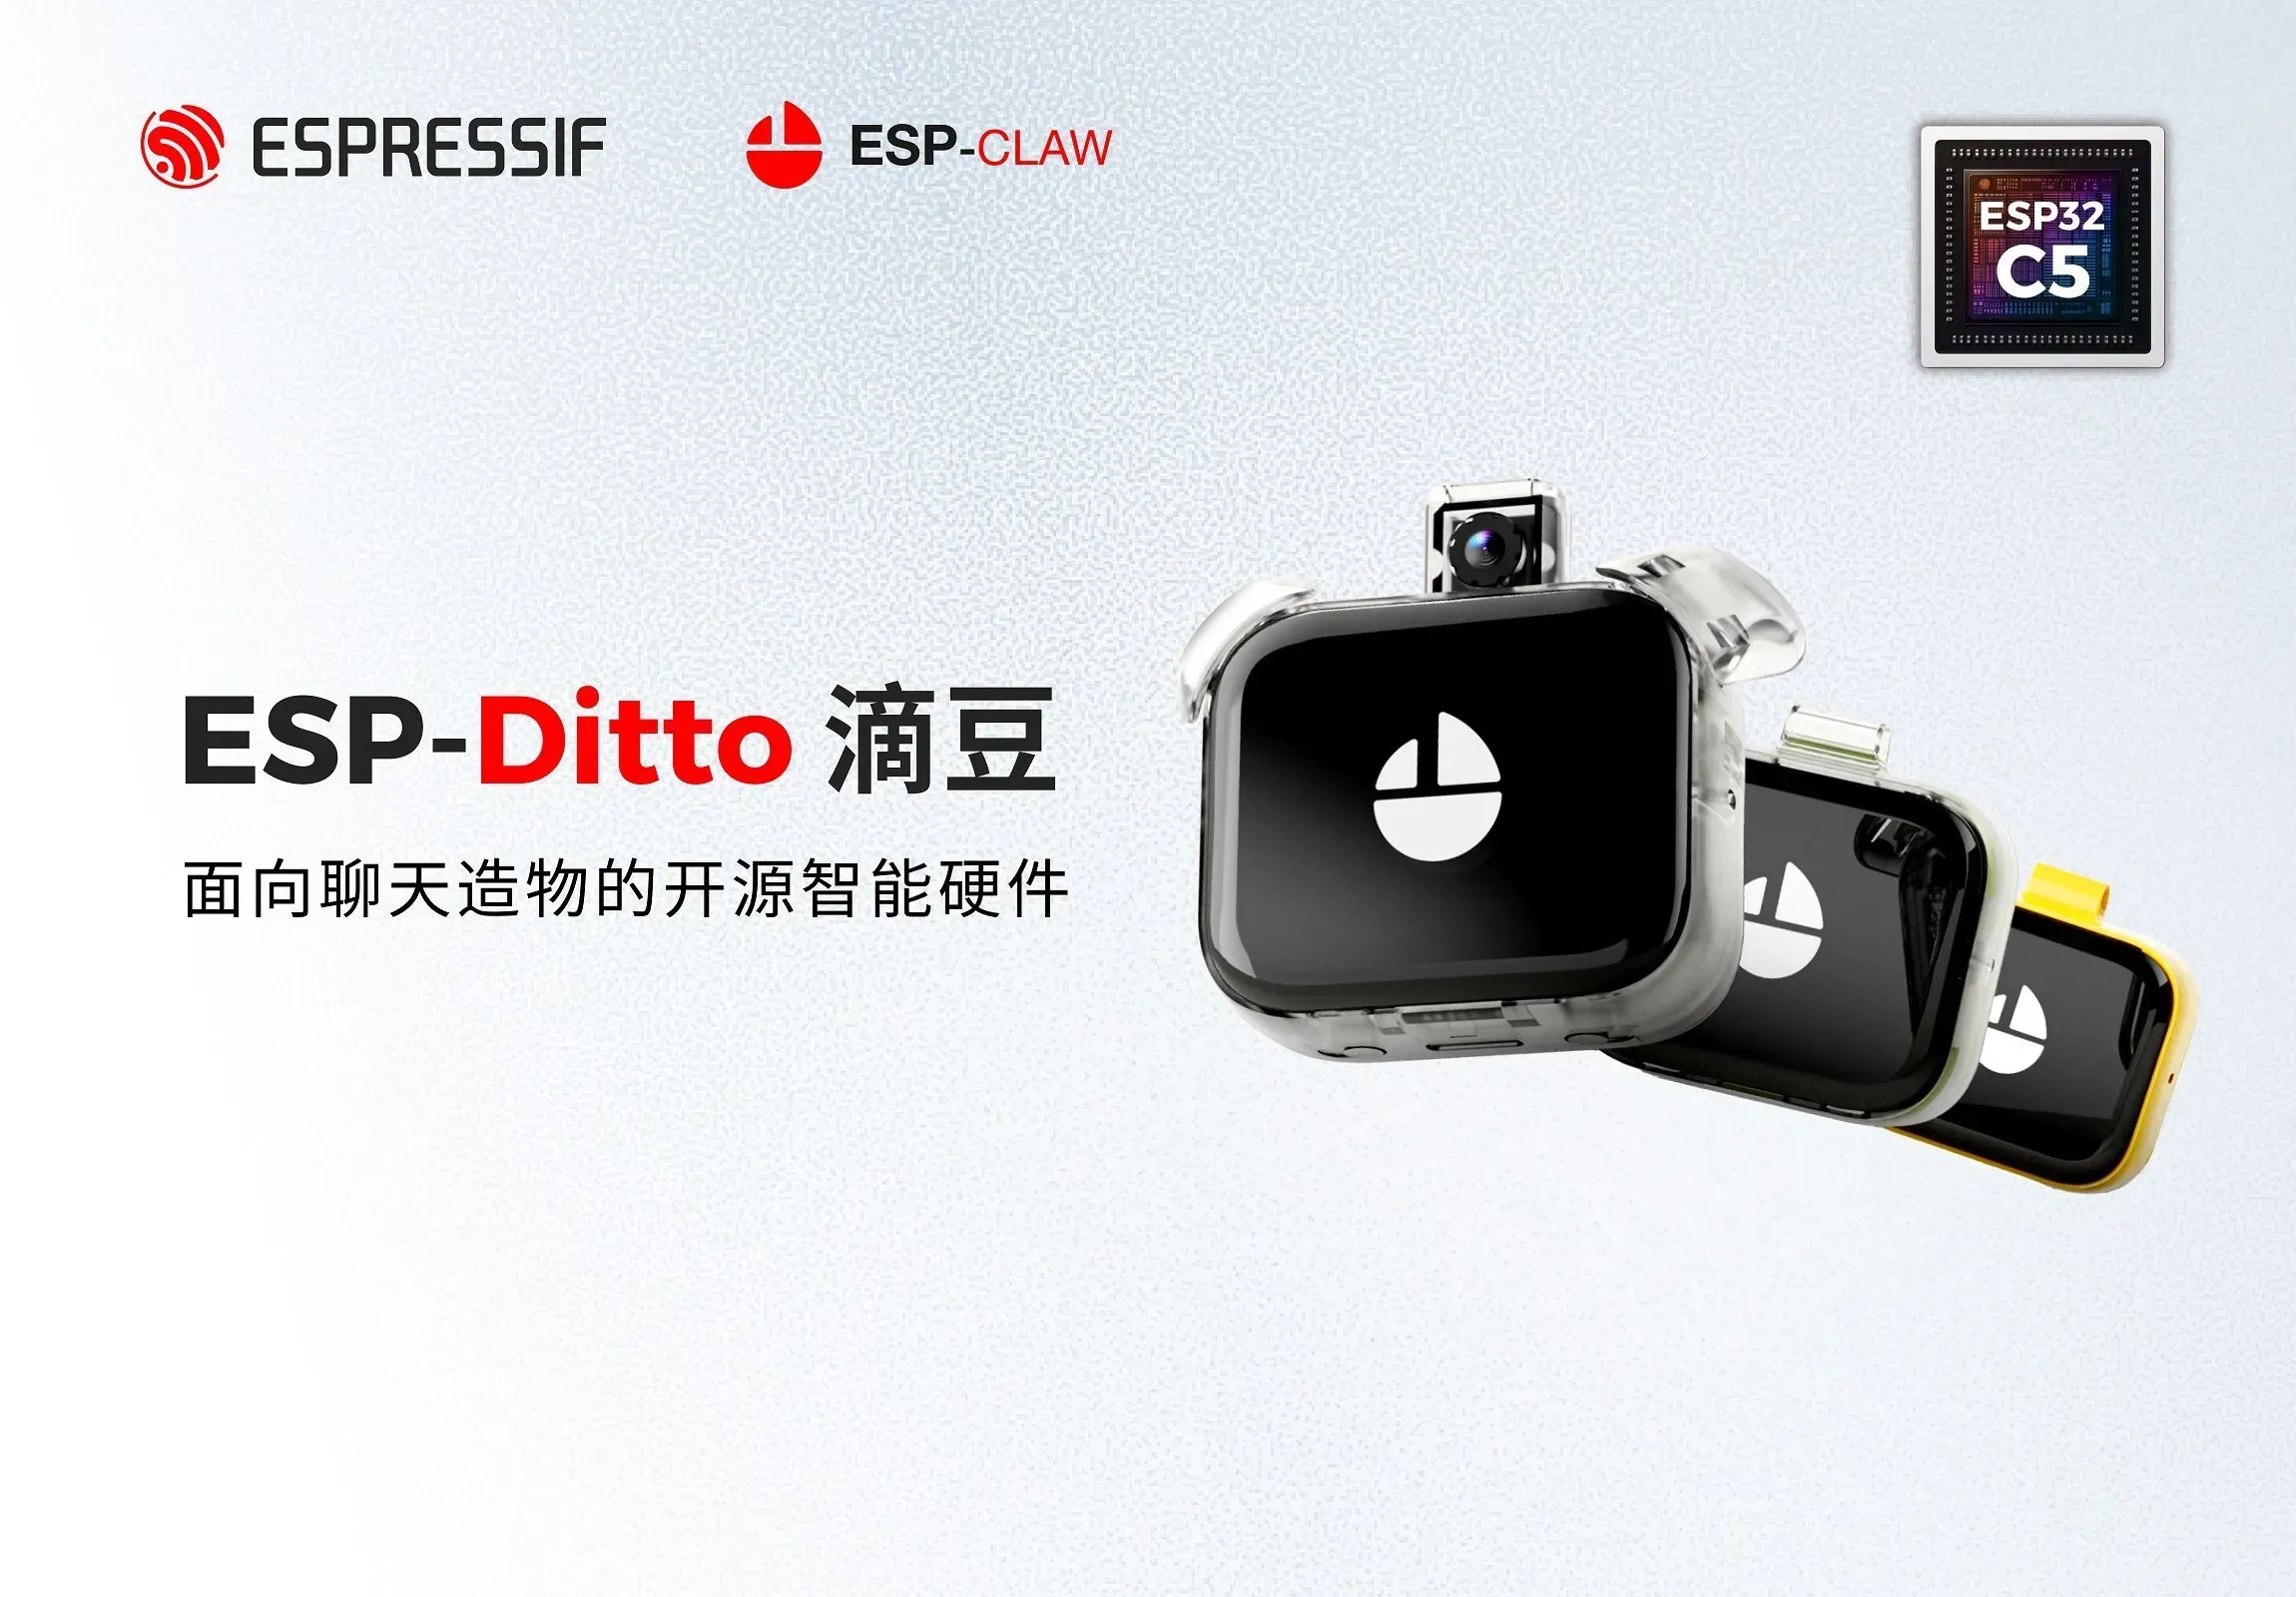 ESP-Ditto 滴豆 · 立创开源项目
ESP-Ditto 基于 ESP32-C5,集成屏幕、麦克风、扬声器与摄像头,可运行 ESP-Claw,参考其语音、屏幕反馈与外设交互方式。它是桌面交互示范,不能直接替代机器人机械动作或本体控制。
 Reachy Mini 对话应用 · 图片来源 · 打开 3D 仿真演示
技术路线:官方应用组合实时语音、角色设定、异步工具和编排动作;工具可调用相机、头部动作等。SDK 和 daemon 管理运动及媒体,提供 MuJoCo 仿真;Lite 连接电脑,Wireless 含机载计算。
公开结果与边界:官方应用展示对话、头部动作、视觉工具和个性设置;仿真可运行 SDK 动作示例,但音频设备与实体不同。中文、噪声表现、网络和各版本能力需现场测试。
Dogtor 可参考:先使用仿真和官方应用理解对话及动作接口,配置 Dogtor 人设和有限工具;增加院所知识检索、拒答、中文语音和运营管理。动作映射到头部及天线,不假设具有手脚。
Furhat · 把说话、注视和表情编排在一起 社交机器人 / 交互设计参考
技术路线:官方 SDK 将语句、注视和表情放入同一交互片段,可定义关键帧动作,也可针对说话等事件触发表情;Virtual Furhat 可模拟头部、注视和表情。
公开结果与边界:文档提供虚拟机器人及语音动作编排能力;虚拟环境存在摄像头和实时口型限制。它是另一产品生态,不能直接套用到 Reachy,也不是 Dogtor 当前采购结论。
Dogtor 可参考:为“聆听、思考、回答、结束”定义轻量动作,按语音开始、结束和错误事件触发;动作幅度、节奏和中断规则需要在 Reachy 实机调校。
推荐系统架构与工程链路
建议路线:Reachy Mini 仿真 → 接待对话 → 桌面实机;链路为语音输入 → 识别与轮次判断 → 审核知识检索 → 回答与语音合成 → 动作编排 → Reachy SDK。
1 · 先跑通平台
按官方指南启动 MuJoCo 仿真和 daemon,验证头部、天线、动作结束和取消;记录 SDK 版本。Lite 与 Wireless 在供电、主机、运行位置及采购支持方面逐项比较,仿真不能替代实物声学测试。
2 · 做自然的中文交流
先采用可观测的语音活动检测、ASR、知识检索、LLM、TTS 链路;支持打断或明确的轮流说话机制,测量每环延迟、误识别与回声。实时语音方案可作后续对照,需另评估中文和数据路径。
3 · 设计角色动作
定义待机、聆听、思考、说话和异常状态:例如聆听时轻微转头,回答开始时点头,结束时回中。通过预设动作、互斥和限幅控制,避免连续对话导致动作排队或冲突。
4 · 适配 Dogtor 外观
先以可拆卸轻量样件评估视觉效果,检查头部运动空间、摄像头、麦克风、扬声器与散热;与厂商确认负载、固定方式、保修及维护。桌面形象是设计目标,尚未证明可实现。
阶段目标效果
桌面 Dogtor 能用中文欢迎访客,围绕审核过的院所资料回答,并以有限头部与天线动作表达聆听和回应。首期以单人、固定场景验证;多人同时说话和嘈杂大厅效果须另测。
第五章 · Implementation
实施规划与技术选型矩阵
两条路线分别建立技术方案和验证基线,能力选型以中文实测决定;验证按四个阶段推进,每阶段有可检查的退出条件,通过后才进入下一阶段。
关键技术选型建议
分别为两条路线建立可观测的验证基线;具体模型以中文测试、部署条件和许可核验结果决定。
| 能力 | 首轮方案与参考 | 验证重点 / 替代选择 |
|---|
| 语音识别 |
先试 Faster Whisper 中文识别,Go2Agent 提供该路径;麦克风音频先做语音活动检测,再交识别服务。 |
用现场距离、噪声和访客口音录制授权样本,比较识别错误与延迟;也可对比 PawAI 使用的 SenseVoice。 |
| 知识问答 |
公开资料按主题分段并保存来源和版本;使用中文或多语向量模型与 FAISS 检索,再让 LLM 基于结果作答,Pepper 项目提供检索参考。 |
测正确回答、依据匹配和无答案拒答;资料很少时可先用人工整理的常见问题匹配作为更易维护的基线。 |
| 语音合成 |
先试听 Piper 的中文声音作为本地候选,Go2Agent 有相应接入;由 TTS 输出驱动说话开始和结束事件。 |
对比可懂度、音色、首包延迟和授权;若本地音色不达要求,再比较符合数据要求的云服务。 |
| 动作编排 |
两条路线分别设计状态机和技能白名单;每个技能实现开始、取消、超时、反馈与资源互斥,分别对接厂商 SDK。 |
先模拟设备断连、重复触发及取消,再测实机;PawAI 的统一执行出口和 Go2Agent 的技能运行时可作设计参考。 |
四项能力各留替代路径:识别可对比 SenseVoice,检索可退回人工整理的常见问题匹配,合成可改用符合数据要求的云服务,编排参考 PawAI 统一执行出口与 Go2Agent 技能运行时;先以中文实测淘汰,再定首轮方案。
分阶段验证
四个阶段的进入条件逐级收紧:第一阶段交付需求清单与候选型号,第二阶段逐题记录回答依据与拒答,第三阶段由厂商和现场人员确认安全条件,第四阶段按事先约定的识别、准确性、延迟与接管标准验收。
| 阶段 | 主要工作 | 可检查的结果 / 进入下一阶段条件 |
|---|
| 1 · 定义场景 |
确认接待内容、机器人形态、场地、数据和厂商接口;收集审核资料。 |
形成需求清单、知识来源、候选型号与供应商待答问题。 |
| 2 · 软件验证 |
建立常见问答与无法回答样本;接语音链路、模拟技能,运行 Reachy 仿真。 |
逐题记录回答依据、错误与拒答;记录识别、首字响应、动作及取消结果。 |
| 3 · 分平台实机 |
启元先读状态再测允许动作;Reachy 测音频、动作和外壳样件。 |
记录型号、版本、环境、成功与失败次数;厂商和现场人员确认安全条件。 |
| 4 · 受控试点 |
在指定区域、工作人员看护下进行端到端接待演示。 |
按双方事先约定的中文识别、回答准确性、延迟、稳定性及人工接管标准验收。 |
待确认清单
当前需要确认的事项:四足狗形是否为硬性要求、是否需要移动引导;启元具体型号与可借用设备、SDK 和动作权限、独立急停与改装条件;Reachy Mini 供货与售后、Lite 或 Wireless、中文语音及桌面部署条件;公开知识审核人、音视频采集和保存要求、云端或本地部署、预算及人员。
- 四足狗形是否为硬性要求?是否需要移动引导?
- 启元具体型号与可借用设备、SDK 和动作权限、独立急停与改装条件。
- Reachy Mini 供货与售后、Lite 或 Wireless、中文语音及桌面部署条件。
- 公开知识审核人、音视频采集和保存要求、云端或本地部署、预算及人员。
第六章 · Appendix
附录:参考资料与术语
以下资料于 2026 年 11 月 3 日查阅;案例能力和许可证可能随版本变化,采购与复用前需核对具体版本、依赖和授权。术语表给出正文使用的缩写。
A. 参考资料
- PawAI 项目仓库(四足多模态系统与执行仲裁):https://github.com/roy4222/PawAI。
- Go2Agent 项目仓库(语音、技能运行时与模拟适配器):https://github.com/SCMU-AILAB/Go2Agent。
- Pepper Medical Assistance 项目仓库(接待业务、检索与机器人桥接):https://github.com/AlyLotfy/Pepper-Medical-Assistance-Robot。
- 启元 T1 SDK(接口、示例和开发要求):https://github.com/PrimebotTech/primebot-t1-sdk。
- 启元开发者资料包(型号与 SDK 入口):https://dev.primebot.com/download。
- Reachy Mini 官方文档(平台与 SDK):https://huggingface.co/docs/reachy_mini/main/index。
- Reachy Mini Conversation App(语音、工具与动作):https://github.com/pollen-robotics/reachy_mini_conversation_app。
- Reachy Mini 仿真指南(仿真与音频差异):https://huggingface.co/docs/reachy_mini/platforms/simulation/get_started。
- Furhat 语音与动作(表达与语句编排):https://docs.furhat.io/skill-development/reference/speech。
- Virtual Furhat 和 SDK(虚拟交互及限制):https://docs.furhat.io/setup/sdk。
B. 术语表
ASR(自动语音识别):把访客语音转为文本,是语音链路的第一环;现场距离、噪声和口音决定它的实测错误率与延迟,需用授权样本先行比较。
TTS(语音合成):把回答文本转为语音输出;由合成事件的开始与结束驱动角色动作,首包延迟与音色可懂度是选型比较项,与授权条款一起评估。
VAD(语音活动检测):判断音频里是否有人在说话,用于语句分段与打断判断;先做检测再交识别服务,可以减少无效识别调用,也是打断机制的判断依据。
LLM(大语言模型):依据检索到的审核资料生成回答,而不是凭记忆作答;无依据时应明确说明不知道并提示工作人员,回答需携带引用来源。
FAISS:向量检索库,按语义相似度查找分段后的知识资料;资料很少时可先退回人工整理的常见问题匹配作为维护基线,检索结果需保存来源与版本。
MuJoCo:物理仿真引擎,Reachy Mini 官方用它在不接硬件时模拟机器人;仿真能验证动作接口,但不能替代实物声学测试。
ROS 2:机器人中间件与开发框架,启元 T1 SDK 的开发基础,提供消息定义、接口说明和 Python/C++ 示例。
SDK(软件开发工具包):厂商提供的接口、消息与示例集合;仓库存在不等于所购版本全部功能开放,能力以具体版本核对为准,接口能力以文档逐项核对。